# Le Fil Rouge Roubaix | Backlinks de qualite et autorite SEO
> Mohamed EL GNANI explique ce qu'est un backlink de qualite en 2026, comment l'evaluer et comment construire un profil qui resiste aux Core Updates.
Corpus complet, edite par Mohamed EL GNANI. Genere le 2026-08-06.
---
# La « part de voix » dans les IA : pourquoi cet indicateur vous trompe déjà
- URL : https://lefilrougeroubaix.fr/posts/part-de-voix-ia-indicateur-trompeur-metriques/
- Publie le : 2026-06-09
- Categorie : General
> La part de voix dans les réponses des IA s'impose comme métrique vedette. Voici pourquoi elle vous induit en erreur et les trois indicateurs à suivre maintenant.
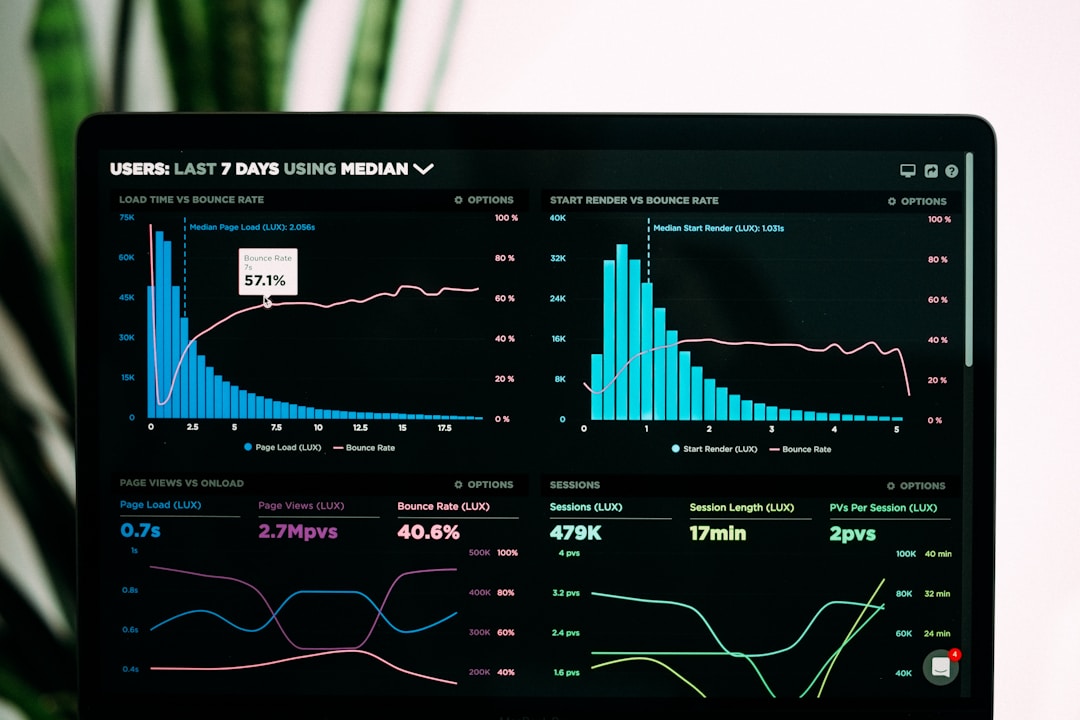
Depuis quelques semaines, une question revient dans presque tous mes échanges avec des clients : « Quelle est notre part de voix dans les réponses des IA ? » La réponse honnête, celle que je donne désormais sans détour, c'est que la question est mal posée. La « part de voix » dans les moteurs conversationnels est en train de devenir l'indicateur à la mode, celui que chacun veut voir trôner en haut d'un tableau de bord. Et c'est justement pour cette raison qu'il faut s'en méfier dès maintenant, avant d'aligner toute une stratégie sur un chiffre qui ne mesure presque rien d'exploitable. Je ne dis pas qu'il faut ignorer sa visibilité dans ChatGPT, Gemini ou les aperçus génératifs de Google. Je dis qu'un score global de « présence moyenne » donne une fausse impression de maîtrise, et qu'il existe trois mesures bien plus utiles pour piloter un travail de fond.
Cet article n'est pas un réquisitoire contre la mesure. C'est un appel à mesurer la bonne chose, au bon moment. Parce que le contexte vient de basculer très vite, et que les décisions prises ces prochains mois sur la base de mauvais indicateurs coûteront cher à rattraper.
## Ce qui vient de basculer en quelques semaines
**Le suivi de la visibilité dans les IA est devenu un marché à part entière, et cela change la donne.** En l'espace de quelques mois, une nouvelle catégorie d'outils a émergé, promettant de vous dire si une intelligence artificielle « recommande votre marque » quand un internaute interroge votre secteur. Le vocabulaire s'est installé : visibilité IA, score de présence, et bien sûr cette fameuse part de voix. Quand un concept se vend aussi bien, c'est rarement parce qu'il est rigoureux. C'est souvent parce qu'il est rassurant.
Deux signaux récents méritent qu'on s'y arrête. D'abord, les outils de mesure officiels commencent à intégrer des rapports dédiés aux performances dans les réponses génératives, avec même la possibilité de contrôler la façon dont vos contenus sont repris dans ces réponses. Autrement dit, la donnée brute commence enfin à exister du côté des éditeurs, là où jusqu'ici on ne disposait que d'estimations bricolées. Ensuite, une statistique m'a fait tiquer : selon des mesures récentes sur le trafic web, les robots représenteraient désormais une majorité des requêtes adressées aux pages, bien plus de la moitié. Une part énorme de ce que vos serveurs servent n'est plus lue par un humain, mais aspirée par des agents qui alimentent des modèles.
Ce double mouvement signifie une chose simple : la visibilité ne se joue plus uniquement dans une page de résultats classée de un à dix. Elle se joue dans la manière dont les machines lisent, citent et restituent vos contenus. Continuer à raisonner avec une seule métrique agrégée, dans ce paysage mouvant, revient à conduire en regardant uniquement le compteur de vitesse alors que la route a complètement changé.
## Pourquoi la part de voix dans les IA est un mirage
**Cet indicateur repose sur une promesse beaucoup plus fragile qu'il n'y paraît.** Pour calculer une part de voix, un outil choisit un panier de questions, les pose plusieurs fois à un ou plusieurs modèles, compte combien de fois votre nom apparaît, puis ramène le tout à un pourcentage. Présenté ainsi, cela semble scientifique. En pratique, chacune de ces étapes introduit un biais que le pourcentage final masque soigneusement.
Premier problème : le panier de questions. C'est vous, ou l'éditeur de l'outil, qui décidez des formulations testées. Or les internautes ne parlent pas comme vos hypothèses. Une part de voix élevée sur trente questions que vous avez choisies ne dit rien de votre présence sur les milliers de variantes réelles, souvent longues, contextuelles, et formulées dans un fil de conversation. Vous mesurez votre reflet dans un miroir que vous avez vous-même orienté.
Deuxième problème : l'instabilité des réponses. Un modèle génératif ne renvoie pas deux fois exactement la même chose. La réponse dépend de la formulation, de l'historique de l'échange, du profil supposé de l'utilisateur, parfois de l'heure et de la zone géographique. Il n'existe plus de classement figé, partagé par tout le monde, comme l'était une page de résultats traditionnelle. Mesurer une « part » dans un environnement qui change à chaque sollicitation, c'est photographier un nuage et prétendre en avoir la forme définitive.
Troisième problème, le plus grave à mes yeux : l'attribution s'effondre. Même en supposant le score juste, il ne vous dit ni pourquoi vous êtes cité, ni dans quel contexte, ni si cette citation a la moindre conséquence sur votre activité. Apparaître dans une réponse à titre d'exemple négatif compte autant, dans le calcul, qu'être présenté comme la référence du secteur. Un chiffre qui additionne le meilleur et le pire en un seul pourcentage n'est pas un indicateur de pilotage, c'est un indicateur de réassurance. Il calme l'inquiétude sans guider l'action.
## Les trois indicateurs qui comptent vraiment
**À la place d'un score global, je suis convaincu qu'il faut suivre trois mesures plus exigeantes mais infiniment plus parlantes.** Elles demandent davantage de travail manuel et un peu de patience, et c'est précisément ce qui les rend précieuses : elles ne se résument pas à un widget que tout le monde peut afficher sans réfléchir.
**Le premier indicateur, c'est le taux de citation sur vos requêtes réellement stratégiques.** Oubliez le panier générique. Identifiez les vingt à cinquante intentions de recherche qui comptent vraiment pour votre activité, celles qui correspondent à un besoin concret de votre audience. Pour chacune, observez régulièrement si vous êtes mentionné, et surtout à quel rang d'évocation. Être cité en premier dans une réponse, là où l'attention se concentre, n'a rien à voir avec une mention noyée en fin de paragraphe. Ce suivi ciblé vous dit où vous gagnez du terrain et où vous êtes invisible, ce qu'aucune moyenne ne révèle.
**Le deuxième indicateur, c'est la nature de la mention, pas seulement sa présence.** Une intelligence artificielle peut vous nommer pour vous recommander, ou simplement pour illustrer un propos, voire pour signaler une réserve. Ces situations n'ont pas la même valeur, et pourtant elles pèsent toutes pareil dans une part de voix. Je conseille de lire les réponses, vraiment les lire, et de classer chaque mention : recommandation explicite, citation neutre, contexte défavorable. Cet examen qualitatif est fastidieux, mais c'est le seul moyen de savoir si la machine vous présente comme un acteur de confiance ou comme un simple nom dans une liste. C'est là que se joue votre réputation auprès des modèles.
**Le troisième indicateur, c'est l'impact en aval : le trafic de référence issu des IA et les conversions qui en découlent.** C'est le juge de paix. Même imparfaite, la mesure du trafic provenant des assistants génératifs progresse, et il devient possible d'isoler ces sessions, d'observer leur comportement et leur taux de transformation. Un visiteur qui arrive après avoir consulté une réponse d'IA est souvent déjà avancé dans sa réflexion : il a délégué une partie de son tri à la machine. Suivre ce que ces visiteurs accomplissent une fois chez vous vaut mille points de part de voix. Si la visibilité ne se traduit jamais par une action, c'est qu'elle n'était qu'un décor.
Ces trois mesures ont un point commun : elles relient la visibilité à une conséquence. Sur quoi suis-je vu, comment suis-je présenté, et qu'est-ce que cela produit. C'est exactement ce qu'un pourcentage agrégé efface.
## Comment reprendre la main dès maintenant
**L'urgence n'est pas d'acheter un nouvel outil, mais de remettre de la méthode avant que les mauvaises habitudes ne se figent.** Voici la démarche que j'applique sur le terrain, et qu'on peut lancer cette semaine sans budget particulier.
Commencez par dresser la liste réelle des questions de votre audience. Pas vos mots-clés favoris : les vraies formulations, celles qu'on entend en clientèle, dans les messages de support, dans les commentaires. Posez-les vous-même aux assistants que votre public utilise, à plusieurs reprises, à quelques jours d'intervalle, et conservez les réponses dans un simple tableau. Vous obtiendrez en deux semaines une photographie bien plus fidèle que n'importe quel score automatisé.
Ensuite, traitez vos contenus comme une matière destinée à être lue par des machines autant que par des humains. Cela ne veut pas dire écrire pour les robots : cela veut dire être clair, structuré, explicite sur qui vous êtes et sur ce que vous affirmez. Les modèles citent volontiers les sources qui énoncent des faits nets, attribuables, faciles à isoler. Une page qui noie son information dans le vague ne donne aucune prise à une citation. La précision devient un atout de visibilité.
Profitez aussi des nouveaux réglages qui apparaissent du côté des outils d'éditeurs pour décider comment vos contenus peuvent être repris dans les réponses génératives. C'est un levier neuf, encore sous-utilisé. Le négliger aujourd'hui, c'est laisser d'autres décider à votre place de la manière dont votre travail circule.
Enfin, fixez un rythme de relevé et tenez-le. Un suivi mensuel, manuel, sur un périmètre restreint mais juste, vaut mieux qu'un tableau de bord temps réel qui agrège du bruit. La régularité fait apparaître les tendances, et ce sont les tendances, pas les scores instantanés, qui doivent orienter vos décisions. Agir maintenant, c'est surtout refuser la facilité du chiffre unique pendant qu'il est encore temps de bâtir une mesure saine.
## FAQ
**La part de voix dans les IA est-elle totalement inutile ?**
Non, pas totalement. Comme repère grossier, elle peut signaler une présence quasi nulle ou une domination écrasante. Le problème surgit quand on en fait l'indicateur central d'une stratégie. Entre ces deux extrêmes, sa zone d'imprécision est immense, et c'est précisément là que se prennent la plupart des décisions. Servez-vous-en comme d'un thermomètre d'ambiance, jamais comme d'un instrument de pilotage fin.
**Comment savoir si une IA me cite positivement ou non ?**
Il n'existe pas de raccourci fiable : il faut lire les réponses. Posez vos questions stratégiques, puis qualifiez chaque mention en trois familles, recommandation, citation neutre, contexte défavorable. En quelques dizaines d'observations, une tendance se dessine. Ce travail paraît artisanal, mais c'est aujourd'hui la seule façon honnête de juger de la qualité de votre présence, et non seulement de sa quantité.
**Faut-il arrêter de produire du contenu pour le référencement classique ?**
Surtout pas. Les contenus clairs, fiables et bien structurés qui servent le référencement traditionnel sont exactement ceux que les modèles aiment citer. Les deux logiques convergent davantage qu'elles ne s'opposent. Ce qui change, c'est la façon de mesurer le résultat : il faut désormais regarder au-delà du simple clic et observer comment votre information est reprise, restituée et prolongée par les machines.
Le vrai risque, en ce moment, n'est pas de manquer un outil de mesure. C'est de se laisser hypnotiser par un chiffre unique au moment précis où le paysage se reconfigure. La visibilité dans les intelligences artificielles n'est pas une course à un pourcentage : c'est une question de réputation auprès de systèmes qui lisent, trient et recommandent en notre nom. Je préfère savoir sur quoi je suis cité, comment je suis présenté et ce que cela déclenche, plutôt que d'afficher un score flatteur que personne ne sait vraiment interpréter. La bonne nouvelle, c'est que les éditeurs commencent à nous donner de vraies données. À nous de ne pas les remplacer aussitôt par une moyenne rassurante. La période qui s'ouvre récompensera ceux qui acceptent de mesurer ce qui est difficile plutôt que ce qui est confortable.
---
# Reddit comme levier SEO : retour sur 5 mois de tests et 12 000 visites mensuelles
- URL : https://lefilrougeroubaix.fr/posts/reddit-comme-levier-seo-retour-sur-5-mois-de-tests-et-12-000/
- Publie le : 2026-04-23
- Categorie : General
> Analyse de la strategie Reddit pour generer du trafic organique. Retour d'experience de Vincent Mercier, chef de projet SEO.
Le jour ou j'ai vu un de mes commentaires Reddit apparaitre en deuxieme position Google sur une requete commerciale, j'ai compris que quelque chose avait change dans le paysage SEO.
Pourquoi Reddit merite votre attention en 2026
L'indexation massive de Reddit par Google a cree une opportunite unique. Vos contributions ne generent pas seulement du trafic depuis Reddit, elles se positionnent aussi dans les resultats organiques Google. Cette double exposition fait de Reddit un canal d'acquisition exceptionnellement rentable.
La preparation : un investissement non negociable
Le warmup est le fondement de toute strategie Reddit. Sans un compte mature avec du karma, vos contributions seront invisibles ou supprimees. Deux semaines minimum d'activite authentique sont necessaires. Certains subreddits exigent meme des seuils de karma specifiques avant d'autoriser les posts.
La strategie qui fonctionne : valeur d'abord, visibilite ensuite
Le tracking d'opportunites fait la difference. Deux outils gratuits suffisent : f5bot.com pour les alertes mot-cle et le mode entreprise Reddit pour le monitoring avance. Quand un thread correspond a votre expertise, intervenez rapidement avec une analyse qui apporte une vraie valeur ajoutee.
Pour approfondir cette methode avec des exemples concrets, ce podcast detaille chaque etape du processus.
Ce que les chiffres disent vraiment
En cumulant trafic direct Reddit et trafic organique via les positions Google, on atteint facilement la barre des 10 000 visites mensuelles. Le ratio temps investi / resultats obtenus ecrase les canaux traditionnels. Et le meilleur : ces positions sont stables dans le temps.
Mon verdict
La transparence s'impose aussi sur les contraintes. Reddit n'est pas automatisable, les multi-comptes sont detectes, et le warmup prend du temps. Cette approche fonctionne mieux dans le digital, la tech et les services B2B que dans l'industrie ou le commerce physique localise. Mais pour ceux qui s'y investissent serieusement, les resultats sont la.
---
# Les 8 règles de prompting qui font la différence sur Claude Opus 4.7
- URL : https://lefilrougeroubaix.fr/posts/8-regles-prompting-claude-opus-47/
- Publie le : 2026-04-17
- Categorie : General
> Les 8 regles de prompting qui font la difference sur Claude Opus 4.7 : contexte, criteres explicites, negations, exemples, niveaux d'effort.
Opus 4.7 est sorti hier 16 avril 2026. Parmi les ajustements à faire sur ses workflows, affiner ses prompts pour tirer le meilleur du modèle reste l'investissement le plus rentable. Voici 8 règles concrètes que j'applique au quotidien.
## Règle 1 : le contexte avant la demande
Ordre qui marche : contexte, contrainte, demande. "Voici la codebase (contexte). Nous visons X (contrainte). Je veux que tu fasses Y (demande)."
L'ordre inverse (demande avant contexte) dilue l'attention sur la tâche. Sur 4.7 qui a un reasoning plus dense, la différence se voit.
## Règle 2 : un critère d'acceptation explicite
"Fais X" est trop vague. "Fais X tel que Y est vrai, Z est respecté, W ne casse pas" donne un vrai cadre.
Cette règle réduit les itérations. Le modèle s'auto-évalue contre les critères avant de te livrer.
## Règle 3 : la négation explicite
Ce que le modèle ne doit PAS faire, dis-le. "Ne modifie pas l'API publique", "n'ajoute pas de dépendance externe", "ne commente pas ce qui est évident".
Sur 4.7 qui a tendance à être plus disciplinépar défaut, ces négations renforcent la précision.
## Règle 4 : un exemple en cas de format custom
Si tu veux un format particulier (JSON structuré, markdown avec sections précises, style de commit), donne UN exemple. Le modèle calibre à partir de l'exemple plus efficacement qu'à partir d'une description.
Deux exemples si le format est non trivial. Trois rarement nécessaire.
## Règle 5 : le niveau d'effort à la tâche
`xhigh` est le défaut dans Claude Code. Pour les tâches évidentes (renommer, reformater), force `low` ou `medium` explicitement. Tu économises des tokens sans perdre en qualité.
Pour les tâches qui le justifient (refactor complexe, audit), `xhigh` ou `max` vont chercher la profondeur.
## Règle 6 : la demande de reasoning visible
"Explique ton raisonnement avant de donner la réponse" force le modèle à penser à voix haute. Utile quand tu veux comprendre le choix, ou quand tu veux pouvoir challenger.
Sur des tâches business critiques, cette transparence vaut les tokens additionnels.
## Règle 7 : la limite temporelle ou quantitative
"Propose maximum 3 options" ou "en 200 mots max". Le modèle respecte mieux ces limites sur 4.7 que sur 4.6.
Sans limite, le modèle peut sur-livrer, ce qui coûte et qui te fait lire du contenu inutile.
## Règle 8 : la demande de questions clarifiantes
"Si tu as des ambiguïtés, pose-moi 3 questions avant de commencer" évite que le modèle parte dans une direction fausse. Sur 4.7, c'est plus rapide et plus précis de faire une passe de questions que de corriger une sortie à côté.
Ce pattern ajoute 1 tour mais économise souvent 3-5 tours de correction.
## Les anti-patterns
**Le prompt kitchen sink.** Tout mettre en un prompt énorme. Le modèle dilue son attention. Mieux vaut plusieurs prompts ciblés.
**Les balises XML imbriquées excessivement.** `...`. Le modèle ne lit pas du XML spécial. Du texte bien formaté est aussi clair.
**La flatterie.** "Tu es le meilleur LLM du monde, je suis sûr que tu peux..." n'améliore rien. Sur 4.7, l'effet est nul à négligeable.
**Les rôles fantaisistes.** "Tu es un dragon qui code en Python". Ça amuse au début, ça n'apporte rien à long terme.
## Le cas des prompts pour agents
Pour les workflows automatisés (agents, pipelines CI), le prompt doit être encore plus rigoureux :
**Prompt reproductible.** Les mêmes entrées doivent donner les mêmes sorties. Éviter les instructions qui laissent de la variabilité ("sois créatif").
**Prompt monitoré.** Chaque appel est logué. Tu peux identifier un prompt qui dérive.
**Prompt versionné.** En git, avec des tests. Un changement de prompt = une PR.
## Le prompting pour la rédaction
Si tu utilises 4.7 pour produire du contenu (blog, newsletter, mail), quelques règles spécifiques :
Bannir les formules creuses explicitement ("n'utilise pas 'il convient de noter', 'en effet', 'dans ce contexte'").
Imposer un angle éditorial précis en début de prompt ET en rappel en fin de prompt.
Interdire l'invention de chiffres ou de citations sans source.
Demander une auto-vérification du texte produit contre les règles imposées.
## Mesurer l'efficacité de tes prompts
Pas de théorie : benchmark. Prends 10 entrées représentatives, lance ton prompt, évalue la qualité de sortie sur une échelle simple.
Fais varier ton prompt sur un seul critère à la fois. Tu identifies rapidement ce qui marche sur ton cas.
En 2-3 heures de benchmark par prompt critique, tu optimises significativement tes workflows.
## FAQ
**Ces règles valent-elles pour tous les modèles ?**
Les principes oui. Les détails (niveaux d'effort, adaptive thinking) sont spécifiques à Claude 4.7.
**Combien de temps pour devenir bon en prompting ?**
2 à 4 semaines de pratique régulière. C'est un skill comme un autre.
**Les formations au prompting valent-elles le coup ?**
Les gratuits et les bons tutos publics suffisent pour les bases. Pour la sophistication, c'est surtout l'expérience.
---
Je dirige Linkuma, plateforme de netlinking low cost avec 40 000 sites au catalogue et 15 000 clients. On maintient une bibliothèque de prompts versionnés pour nos différents agents. Retours terrain sur linkuma.com, promos hebdo sur deals.linkuma.com.
---
# Claude Managed Agents : le harness d agents autonomes d Anthropic en beta publique
- URL : https://lefilrougeroubaix.fr/posts/claude-managed-agents-harness-agents-autonomes-anthropic-beta-publique/
- Publie le : 2026-04-10
- Categorie : General
> Anthropic lance Claude Managed Agents en beta publique en avril 2026. Un harness complet pour executer Claude comme agent autonome avec sandboxing securise et streaming SSE.
Claude Managed Agents : le harness d agents autonomes d Anthropic en beta publique
Claude Managed Agents est un service d Anthropic lance en beta publique le 8 avril 2026. C est un harness entierement gere qui permet d executer Claude comme agent autonome avec sandboxing securise, outils integres et streaming d evenements en temps reel via server-sent events (SSE). Le service tourne sur l infrastructure Anthropic et elimine la necessite de construire soi-meme l orchestration d agents, la gestion des outils ou l isolation de securite. Il est accessible via l API Claude et le nouveau CLI ant.
Quel probleme les Managed Agents resolvent-ils pour les equipes de dev ?
Construire un agent autonome a partir de l API Claude demande de resoudre plusieurs problemes d infrastructure en meme temps. L orchestration des appels en boucle quand l agent doit utiliser plusieurs outils. Le sandboxing pour empecher un agent de faire des degats sur le systeme hote. La gestion des timeouts et des erreurs quand un agent tourne pendant plusieurs minutes. Le streaming des resultats intermediaires pour que l utilisateur sache ce qui se passe. Les Managed Agents encapsulent tout ca dans un service gere : on envoie un prompt, le harness gere l execution, les outils, le sandboxing et le streaming. C est la difference entre deployer un conteneur Docker soi-meme et utiliser un service gere comme AWS Lambda.
Comment fonctionne le sandboxing securise ?
Chaque agent tourne dans un environnement isole sur l infrastructure Anthropic. L agent peut executer du code, lire et ecrire des fichiers, et utiliser des outils, mais tout est confine dans un sandbox. Le mecanisme est similaire a l isolation PID namespace introduite dans Claude Code v2.1.98 avec la variable CLAUDE_CODE_SUBPROCESS_ENV_SCRUB, mais applique cote serveur. L agent n a pas acces au reseau hote, au systeme de fichiers de la machine, ou aux credentials de l environnement de production. C est un pre-requis pour les cas d usage entreprise ou l agent manipule du code ou des donnees sensibles.
Comment le streaming SSE change l experience utilisateur ?
Sans streaming, on envoie un prompt a un agent et on attend la reponse finale. Si l agent met 3 minutes a executer 12 etapes d outils, l utilisateur ne voit rien pendant 3 minutes. Avec le streaming SSE des Managed Agents, chaque etape de l agent emet un evenement en temps reel. L application cliente recoit les resultats intermediaires au fur et a mesure : outil appele, resultat obtenu, reflexion de l agent, prochain outil. Le format est le meme server-sent events utilise par l API Claude pour le streaming de tokens, ce qui simplifie l integration cote client.
Quels outils sont integres au harness ?
Les Managed Agents incluent un ensemble d outils built-in pour les cas d usage courants : execution de code, lecture et ecriture de fichiers, navigation web. L agent peut aussi utiliser des outils custom definis par l utilisateur via le format d outils de l API Claude. La difference avec l API standard est que le harness gere la boucle d orchestration automatiquement. Quand l agent decide d utiliser un outil, le harness l execute, renvoie le resultat a Claude, et continue la boucle jusqu a ce que l agent ait termine. Pas besoin de gerer cette boucle cote client.
Comment acceder aux Managed Agents en avril 2026 ?
Le service est en beta publique depuis le 8 avril 2026. L acces se fait via l API Claude avec un header specifique. Anthropic a aussi lance ant, un CLI pour l API Claude qui supporte nativement les Managed Agents. Le CLI ant permet de versionner les ressources API en YAML et de lancer des agents depuis le terminal. L integration avec Claude Code est native : on peut utiliser les Managed Agents depuis une session Claude Code sans configuration supplementaire. Le service tourne sur l infrastructure Anthropic, ce qui signifie qu il n est pas disponible pour les deployments Bedrock ou Vertex AI (meme restriction qu Ultraplan).
En resume, Claude Managed Agents est le premier harness d agents autonomes gere par Anthropic, lance en beta publique en avril 2026. Sandboxing securise, outils integres, streaming SSE et integration CLI ant : c est la brique qui manquait entre l API Claude brute et les frameworks d agents tiers comme LangChain ou CrewAI. Disponible via l API et le CLI ant pour les utilisateurs avec cle API.
---
# Qu'est-ce qu'un backlink de qualite en 2026 : grille d'evaluation complete
- URL : https://lefilrougeroubaix.fr/posts/bienvenue/
- Publie le : 2026-04-09
- Categorie : General
> Oublie les metriques bidon. Voici les 10 criteres qui definissent un vrai backlink de qualite en 2026, avec la grille d'evaluation que j'utilise chez Linkuma.
## On va arreter le bullshit
J'en ai marre de lire des guides SEO qui definissent un "bon backlink" par "DR50 et trafic 1000". C'est faux, c'est paresseux, et ca coute cher aux gens qui y croient.
Je suis Mohamed EL GNANI, je dirige Linkuma, et j'ai passe des annees a affiner ma grille d'evaluation des backlinks. Dans ce premier article sur Le Fil Rouge Roubaix, je te donne ma methodologie complete. Pas de marketing, pas de raccourcis, juste les criteres que j'utilise reellement.
## Les 10 criteres d'un backlink de qualite
### 1. La coherence thematique avec ta page cible
C'est le critere numero 1, et de loin. Un lien depuis un article qui parle de ton sujet precis vaut 10 fois plus qu'un lien depuis un site generaliste. Google mesure la pertinence semantique entre la page source et la page cible. C'est la base du fonctionnement du scoring depuis au moins 2018.
Verification concrete : le texte autour du lien parle-t-il vraiment du meme sujet que ta page cible. Si non, tu achetes du vent.
### 2. Le trafic organique REEL du site
Attention : pas le trafic estime par Ahrefs ou Semrush, le trafic reel mesurable. Un site peut avoir des estimations Ahrefs flatteuses mais en realite ne recevoir que 200 visites par mois. Croise toujours plusieurs outils et regarde les signaux comportementaux.
### 3. L'activite editoriale reguliere
Un site qui publie regulierement sur les 12 derniers mois est un site vivant, donc crediblement indexe par Google. Un site qui n'a rien publie depuis 8 mois est un signal de stagnation. Un bon backlink vient d'un site actif.
### 4. La diversite du profil de liens sortants
Si un site a 500 liens sortants tous en exact match, c'est un mauvais signal. Un profil editorial sain montre une diversite d'ancres, de contextes et de destinations. Regarde le rapport Ahrefs "Outgoing Links" avant d'acheter un lien sur un site.
### 5. Le ratio do/nofollow des liens sortants
Un site qui a 95 pour cent de liens sortants dofollow est probablement une ferme a liens. Un ratio sain tourne autour de 70 a 80 pour cent dofollow, avec quelques nofollow legitimes (sources externes, citations).
### 6. L'anciennete et la stabilite
Un domaine qui existe depuis 5 ans avec un historique stable vaut mieux qu'un domaine de 6 mois. Mais attention : un domaine ancien mal utilise peut etre pire qu'un jeune domaine propre.
### 7. La qualite du site cible dans son ensemble
Si le site qui linke est lui-meme mal structure, lent, bourre de publicites et sans politique de confidentialite, ton lien vaut moins. Le jus qui te transmet est proportionnel a la sante du site source.
### 8. La position du lien dans la page
Un lien en plein coeur d'un article editorial vaut plus qu'un lien en footer ou en sidebar. Google donne plus de poids aux liens "editoriaux" integres dans le flow du texte.
### 9. L'environnement concurrentiel
Si ton lien est entoure de 20 autres liens dans la meme page, son poids diminue. Les liens qui entourent le tien doivent etre limites en nombre.
### 10. L'ancre elle-meme
Une ancre trop optimisee (exact match pure) sur un site deja charge en ancres optimisees, c'est contre-productif. Une ancre brand ou generique peut etre plus saine pour ton profil.
## Ma grille de scoring
Pour chaque lien potentiel, je note de 0 a 10 sur les 10 criteres ci-dessus. Resultat :
- Score total au-dessus de 75 : lien premium, j'y vais
- Score entre 50 et 75 : lien correct, a mettre dans le pool
- Score en dessous de 50 : je passe mon tour
Ca prend environ 10 minutes par site a evaluer. C'est long, mais ca evite les erreurs couteuses.
## Ce que Linkuma apporte sur ces criteres
Chez Linkuma, les sites du catalogue (plus de 40 000) sont selectionnes et categorises pour que tu puisses directement filtrer par thematique. Les tarifs demarrent a 5 euros pour les sites generalistes, 10 euros pour les thematiques, 30 euros et plus pour les sites premium. L'expert SEO gratuit fourni avec chaque compte t'aide a construire un profil sain, et l'audit de profil de liens est offert aux nouveaux inscrits. Plus de 15 000 clients et 600 avis positifs valident l'approche. Les deals hebdomadaires sur deals.linkuma.com permettent d'acceder a des sites premium a tarif reduit.
## Les pieges courants
- Se fier aveuglement au DR ou au DA
- Ignorer la thematique en faveur du "trafic"
- Acheter en batch sans analyse individuelle
- Negliger les liens sortants de la page hote
- Ne pas regarder l'historique de sanction du site
## Pour conclure
Un backlink de qualite en 2026 n'est pas defini par une seule metrique magique, mais par un ensemble de signaux. Plus tu es rigoureux dans ton evaluation, plus ton profil de liens sera sain et resistant aux Core Updates.
Je continuerai a decortiquer ces sujets sur Le Fil Rouge Roubaix, avec des cas concrets, des grilles reutilisables et des retours d'experience. Chez Linkuma, on met a disposition plus de 40 000 sites, des tarifs a partir de 5 euros et un accompagnement humain gratuit. Les deals de la semaine sont sur deals.linkuma.com.
Prochain article : comment reperer un site ferme a liens en 3 minutes chrono.
Mohamed
